mirror of
https://github.com/trekhleb/javascript-algorithms.git
synced 2026-03-13 08:51:02 +08:00
Brazilian Portuguese translation and typos fixes (#943)
* Update README.pt-BR.md

* TRIE README.pt-BR typo

* TREE README.pt-BR typo

* Stack README.pt-BR typo

* Priority Queue README.pt-BR typo

* hash-table README.pt-BR typo

* doubly-linked-list README.pt-BR typo

* disjoint-set README.pt-BR typo

* bloom-filter README.pt-BR typo

* merge-sort pt-BR translation

* merge-sort README added pt-BR option

* insertion sort pt-BR translation

* insertion sort README added pt-br option

* heap-sort pt-BR translation

* heap-sort READMED added pt-BR option

* bubble sort pt-BR typo

* pt-BR translation for sorting algorithms

Fixed typos and translated all the missing algorithms

* Update README.pt-BR.md

* linked list pt-BR translation

* ml pt-BR translation

* fix typo in README

Co-authored-by: Oleksii Trekhleb <trehleb@gmail.com>
This commit is contained in:
 Mateus Pfeffer
@@ -1,7 +1,8 @@
|
||||
# Reversed Linked List Traversal
|
||||
|
||||
_Read this in other languages:_
|
||||
[中文](README.zh-CN.md)
|
||||
[_中文_](README.zh-CN.md),
|
||||
[_Português_](README.pt-BR.md)
|
||||
|
||||
The task is to traverse the given linked list in reversed order.
|
||||
|
||||
|
||||
23
src/algorithms/linked-list/reverse-traversal/README.pt-BR.md
Normal file
23
src/algorithms/linked-list/reverse-traversal/README.pt-BR.md
Normal file
@@ -0,0 +1,23 @@
|
||||
# Travessia de Lista Encadeada Reversa
|
||||
|
||||
_Leia isso em outros idiomas:_
|
||||
[_中文_](README.zh-CN.md),
|
||||
[_English_](README.md)
|
||||
|
||||
A tarefa é percorrer a lista encadeada fornecida em ordem inversa.
|
||||
|
||||
Por exemplo, para a seguinte lista vinculada:
|
||||
|
||||

|
||||
|
||||
A ordem de travessia deve ser:
|
||||
|
||||
```texto
|
||||
37 → 99 → 12
|
||||
```
|
||||
|
||||
A complexidade de tempo é `O(n)` porque visitamos cada nó apenas uma vez.
|
||||
|
||||
## Referência
|
||||
|
||||
- [Wikipedia](https://en.wikipedia.org/wiki/Linked_list)
|
||||
@@ -2,7 +2,8 @@
|
||||
|
||||
_Read this in other languages:_
|
||||
[_Русский_](README.ru-RU.md),
|
||||
[中文](README.zh-CN.md)
|
||||
[_中文_](README.zh-CN.md),
|
||||
[_Português_](README.pt-BR.md)
|
||||
|
||||
The task is to traverse the given linked list in straight order.
|
||||
|
||||
|
||||
24
src/algorithms/linked-list/traversal/README.pt-BR.md
Normal file
24
src/algorithms/linked-list/traversal/README.pt-BR.md
Normal file
@@ -0,0 +1,24 @@
|
||||
# Travessia de Lista Encadeada
|
||||
|
||||
_Leia isso em outros idiomas:_
|
||||
[_Русский_](README.ru-RU.md),
|
||||
[_中文_](README.zh-CN.md),
|
||||
[_English_](README.md)
|
||||
|
||||
A tarefa é percorrer a lista encadeada fornecida em ordem direta.
|
||||
|
||||
Por exemplo, para a seguinte lista vinculada:
|
||||
|
||||

|
||||
|
||||
A ordem de travessia deve ser:
|
||||
|
||||
```texto
|
||||
12 → 99 → 37
|
||||
```
|
||||
|
||||
A complexidade de tempo é `O(n)` porque visitamos cada nó apenas uma vez.
|
||||
|
||||
## Referência
|
||||
|
||||
- [Wikipedia](https://en.wikipedia.org/wiki/Linked_list)
|
||||
@@ -1,5 +1,8 @@
|
||||
# k-Means Algorithm
|
||||
|
||||
_Read this in other languages:_
|
||||
[_Português_](README.pt-BR.md)
|
||||
|
||||
The **k-Means algorithm** is an unsupervised Machine Learning algorithm. It's a clustering algorithm, which groups the sample data on the basis of similarity between dimensions of vectors.
|
||||
|
||||
In k-Means classification, the output is a set of classes assigned to each vector. Each cluster location is continuously optimized in order to get the accurate locations of each cluster such that they represent each group clearly.
|
||||
|
||||
35
src/algorithms/ml/k-means/README.pt-BR.md
Normal file
35
src/algorithms/ml/k-means/README.pt-BR.md
Normal file
@@ -0,0 +1,35 @@
|
||||
# Algoritmo k-Means
|
||||
|
||||
_Leia isso em outros idiomas:_
|
||||
[_English_](README.md)
|
||||
|
||||
O **algoritmo k-Means** é um algoritmo de aprendizado de máquina não supervisionado. É um algoritmo de agrupamento, que agrupa os dados da amostra com base na semelhança entre as dimensões dos vetores.
|
||||
|
||||
Na classificação k-Means, a saída é um conjunto de classes atribuídas a cada vetor. Cada localização de cluster é continuamente otimizada para obter as localizações precisas de cada cluster de forma que representem cada grupo claramente.
|
||||
|
||||
A ideia é calcular a similaridade entre a localização do cluster e os vetores de dados e reatribuir os clusters com base nela. [Distância Euclidiana](https://github.com/trekhleb/javascript-algorithms/tree/master/src/algorithms/math/euclidean-distance) é usado principalmente para esta tarefa.
|
||||
|
||||

|
||||
|
||||
_Fonte: [Wikipedia](https://en.wikipedia.org/wiki/Euclidean_distance)_
|
||||
|
||||
O algoritmo é o seguinte:
|
||||
|
||||
1. Verifique se há erros como dados inválidos/inconsistentes
|
||||
2. Inicialize os locais do cluster `k` com pontos `k` iniciais/aleatórios
|
||||
3. Calcule a distância de cada ponto de dados de cada cluster
|
||||
4. Atribua o rótulo do cluster de cada ponto de dados igual ao do cluster em sua distância mínima
|
||||
5. Calcule o centroide de cada cluster com base nos pontos de dados que ele contém
|
||||
6. Repita cada uma das etapas acima até que as localizações do centroide estejam variando
|
||||
|
||||
Aqui está uma visualização do agrupamento k-Means para melhor compreensão:
|
||||
|
||||

|
||||
|
||||
_Fonte: [Wikipedia](https://en.wikipedia.org/wiki/K-means_clustering)_
|
||||
|
||||
Os centroides estão se movendo continuamente para criar uma melhor distinção entre os diferentes conjuntos de pontos de dados. Como podemos ver, após algumas iterações, a diferença de centroides é bastante baixa entre as iterações. Por exemplo, entre as iterações `13` e `14` a diferença é bem pequena porque o otimizador está ajustando os casos limite.
|
||||
|
||||
## Referências
|
||||
|
||||
- [k-Means neighbors algorithm on Wikipedia](https://en.wikipedia.org/wiki/K-means_clustering)
|
||||
@@ -1,5 +1,8 @@
|
||||
# k-Nearest Neighbors Algorithm
|
||||
|
||||
_Read this in other languages:_
|
||||
[_Português_](README.pt-BR.md)
|
||||
|
||||
The **k-nearest neighbors algorithm (k-NN)** is a supervised Machine Learning algorithm. It's a classification algorithm, determining the class of a sample vector using a sample data.
|
||||
|
||||
In k-NN classification, the output is a class membership. An object is classified by a plurality vote of its neighbors, with the object being assigned to the class most common among its `k` nearest neighbors (`k` is a positive integer, typically small). If `k = 1`, then the object is simply assigned to the class of that single nearest neighbor.
|
||||
|
||||
44
src/algorithms/ml/knn/README.pt-BR.md
Normal file
44
src/algorithms/ml/knn/README.pt-BR.md
Normal file
@@ -0,0 +1,44 @@
|
||||
# Algoritmo de k-vizinhos mais próximos
|
||||
|
||||
_Leia isso em outros idiomas:_
|
||||
[_English_](README.md)
|
||||
|
||||
O **algoritmo de k-vizinhos mais próximos (k-NN)** é um algoritmo de aprendizado de máquina supervisionado. É um algoritmo de classificação, determinando a classe de um vetor de amostra usando dados de amostra.
|
||||
|
||||
Na classificação k-NN, a saída é uma associação de classe. Um objeto é classificado por uma pluralidade de votos de seus vizinhos, com o objeto sendo atribuído à classe mais comum entre seus `k` vizinhos mais próximos (`k` é um inteiro positivo, tipicamente pequeno). Se `k = 1`, então o objeto é simplesmente atribuído à classe daquele único vizinho mais próximo.
|
||||
|
||||
The idea is to calculate the similarity between two data points on the basis of a distance metric. [Distância Euclidiana](https://github.com/trekhleb/javascript-algorithms/tree/master/src/algorithms/math/euclidean-distance) é usado principalmente para esta tarefa.
|
||||
|
||||

|
||||
|
||||
_Fonte: [Wikipedia](https://en.wikipedia.org/wiki/Euclidean_distance)_
|
||||
|
||||
O algoritmo é o seguinte:
|
||||
|
||||
1. Verifique se há erros como dados/rótulos inválidos.
|
||||
2. Calcule a distância euclidiana de todos os pontos de dados nos dados de treinamento com o ponto de classificação
|
||||
3. Classifique as distâncias dos pontos junto com suas classes em ordem crescente
|
||||
4. Pegue as classes iniciais `K` e encontre o modo para obter a classe mais semelhante
|
||||
5. Informe a classe mais semelhante
|
||||
|
||||
Aqui está uma visualização da classificação k-NN para melhor compreensão:
|
||||
|
||||

|
||||
|
||||
_Fonte: [Wikipedia](https://en.wikipedia.org/wiki/K-nearest_neighbors_algorithm)_
|
||||
|
||||
A amostra de teste (ponto verde) deve ser classificada em quadrados azuis ou em triângulos vermelhos. Se `k = 3` (círculo de linha sólida) é atribuído aos triângulos vermelhos porque existem `2` triângulos e apenas `1` quadrado dentro do círculo interno. Se `k = 5` (círculo de linha tracejada) é atribuído aos quadrados azuis (`3` quadrados vs. `2` triângulos dentro do círculo externo).
|
||||
|
||||
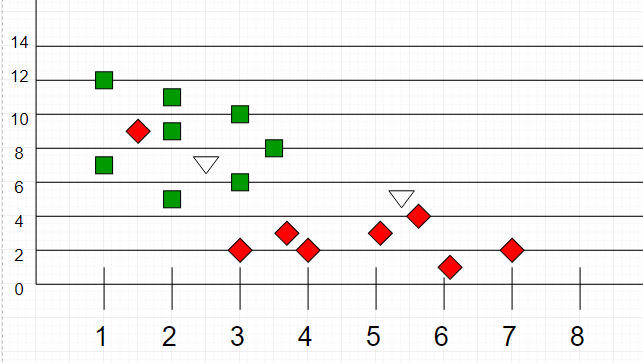
Outro exemplo de classificação k-NN:
|
||||
|
||||
|
||||
|
||||
_Fonte: [GeeksForGeeks](https://media.geeksforgeeks.org/wp-content/uploads/graph2-2.png)_
|
||||
|
||||
Aqui, como podemos ver, a classificação dos pontos desconhecidos será julgada pela proximidade com outros pontos.
|
||||
|
||||
É importante notar que `K` é preferível ter valores ímpares para desempate. Normalmente `K` é tomado como `3` ou `5`.
|
||||
|
||||
## Referências
|
||||
|
||||
- [k-nearest neighbors algorithm on Wikipedia](https://en.wikipedia.org/wiki/K-nearest_neighbors_algorithm)
|
||||
@@ -1,16 +1,19 @@
|
||||
# Bubble Sort
|
||||
|
||||
_Leia isso em outros idiomas:_
|
||||
[_English_](README.md)
|
||||
|
||||
O bubble sort, ou ordenação por flutuação (literalmente "por bolha"), é um algoritmo de ordenação dos mais simples. A ideia é percorrer o vetor diversas vezes, e a cada passagem fazer flutuar para o topo o maior elemento da sequência. Essa movimentação lembra a forma como as bolhas em um tanque de água procuram seu próprio nível, e disso vem o nome do algoritmo.
|
||||
|
||||
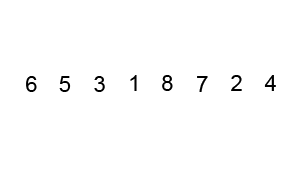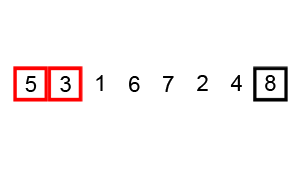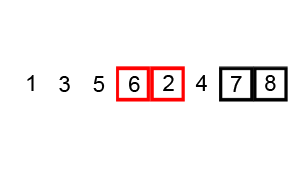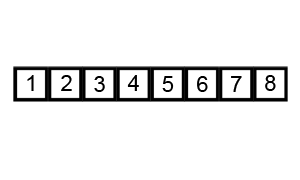
|
||||
|
||||
## Complexity
|
||||
## Complexidade
|
||||
|
||||
| Name | Best | Average | Worst | Memory | Stable | Comments |
|
||||
| Nome | Melhor | Média | Pior | Memória | Estável | Comentários |
|
||||
| --------------------- | :-------------: | :-----------------: | :-----------------: | :-------: | :-------: | :-------- |
|
||||
| **Bubble sort** | n | n<sup>2</sup> | n<sup>2</sup> | 1 | Yes | |
|
||||
| **Bubble sort** | n | n<sup>2</sup> | n<sup>2</sup> | 1 | Sim | |
|
||||
|
||||
## References
|
||||
## Referências
|
||||
|
||||
- [Wikipedia](https://pt.wikipedia.org/wiki/Bubble_sort)
|
||||
- [YouTube](https://www.youtube.com/watch?v=6Gv8vg0kcHc&index=27&t=0s&list=PLLXdhg_r2hKA7DPDsunoDZ-Z769jWn4R8)
|
||||
|
||||
@@ -1,5 +1,8 @@
|
||||
# Counting Sort
|
||||
|
||||
_Read this in other languages:_
|
||||
[_Português_](README.pt-BR.md)
|
||||
|
||||
In computer science, **counting sort** is an algorithm for sorting
|
||||
a collection of objects according to keys that are small integers;
|
||||
that is, it is an integer sorting algorithm. It operates by
|
||||
|
||||
70
src/algorithms/sorting/counting-sort/README.pt-br.md
Normal file
70
src/algorithms/sorting/counting-sort/README.pt-br.md
Normal file
@@ -0,0 +1,70 @@
|
||||
# Counting Sort
|
||||
|
||||
_Leia isso em outros idiomas:_
|
||||
[_English_](README.md)
|
||||
|
||||
Em ciência da computação, **counting sort** é um algoritmo para ordenar
|
||||
uma coleção de objetos de acordo com chaves que são pequenos inteiros;
|
||||
ou seja, é um algoritmo de ordenação de inteiros. Ele opera por
|
||||
contando o número de objetos que têm cada valor de chave distinto,
|
||||
e usando aritmética nessas contagens para determinar as posições
|
||||
de cada valor de chave na sequência de saída. Seu tempo de execução é
|
||||
linear no número de itens e a diferença entre o
|
||||
valores de chave máximo e mínimo, portanto, é adequado apenas para
|
||||
uso em situações em que a variação de tonalidades não é significativamente
|
||||
maior que o número de itens. No entanto, muitas vezes é usado como
|
||||
sub-rotina em outro algoritmo de ordenação, radix sort, que pode
|
||||
lidar com chaves maiores de forma mais eficiente.
|
||||
|
||||
Como a classificação por contagem usa valores-chave como índices em um vetor,
|
||||
não é uma ordenação por comparação, e o limite inferior `Ω(n log n)` para
|
||||
a ordenação por comparação não se aplica a ele. A classificação por bucket pode ser usada
|
||||
para muitas das mesmas tarefas que a ordenação por contagem, com um tempo semelhante
|
||||
análise; no entanto, em comparação com a classificação por contagem, a classificação por bucket requer
|
||||
listas vinculadas, arrays dinâmicos ou uma grande quantidade de pré-alocados
|
||||
memória para armazenar os conjuntos de itens dentro de cada bucket, enquanto
|
||||
A classificação por contagem armazena um único número (a contagem de itens)
|
||||
por balde.
|
||||
|
||||
A classificação por contagem funciona melhor quando o intervalo de números para cada
|
||||
elemento do vetor é muito pequeno.
|
||||
|
||||
## Algoritmo
|
||||
|
||||
**Passo I**
|
||||
|
||||
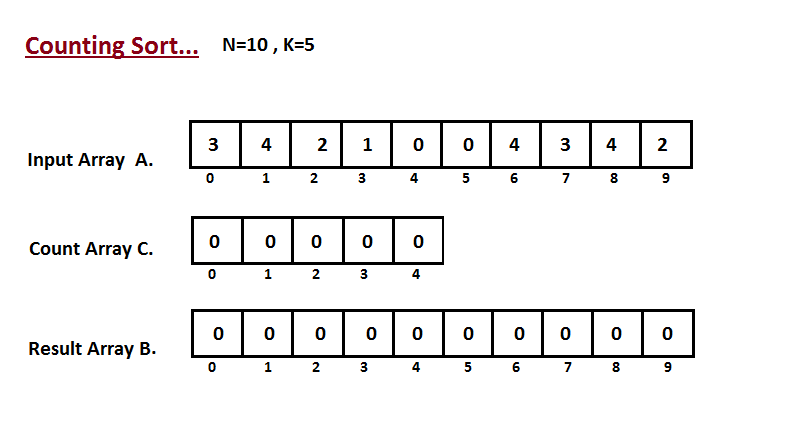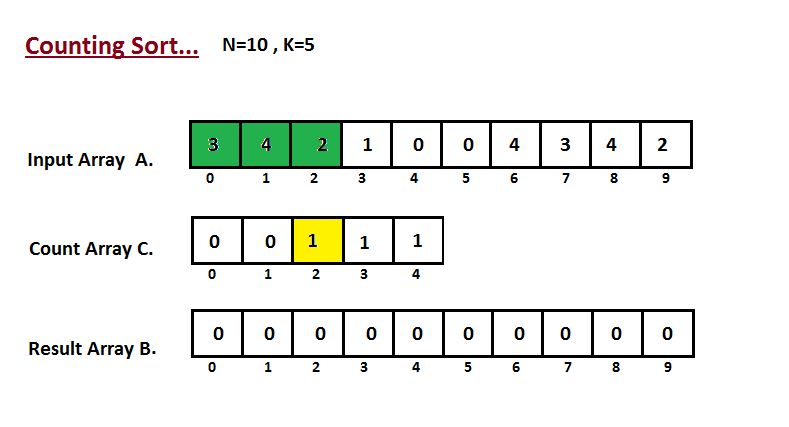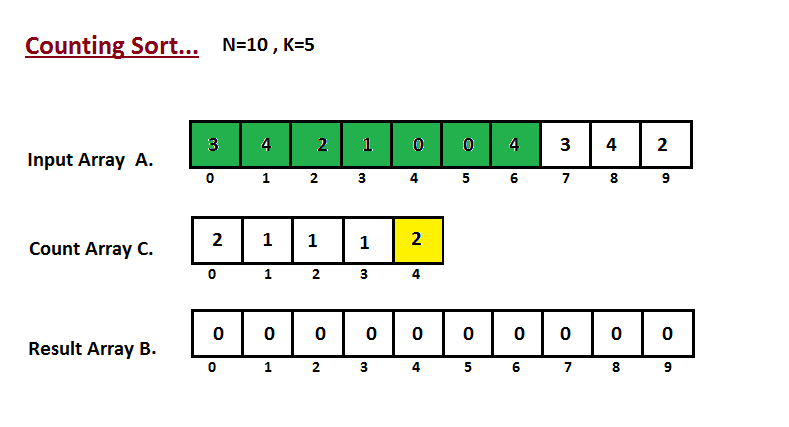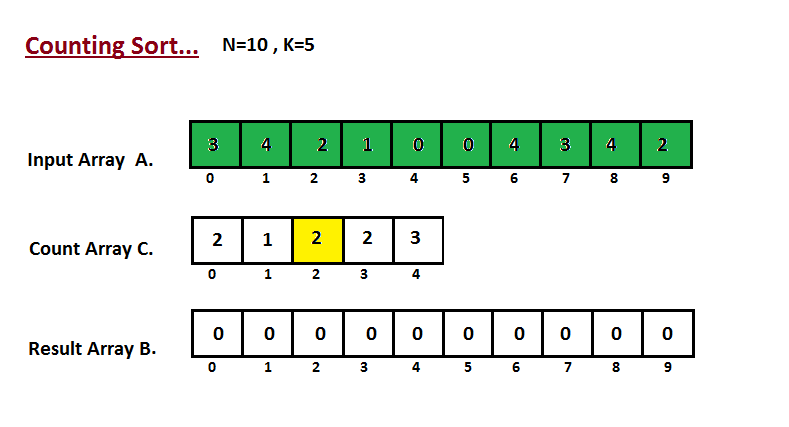
Na primeira etapa, calculamos a contagem de todos os elementos do
|
||||
vetor de entrada 'A'. Em seguida, armazene o resultado no vetor de contagem `C`.
|
||||
A maneira como contamos é descrita abaixo.
|
||||
|
||||
|
||||
|
||||
**Passo II**
|
||||
|
||||
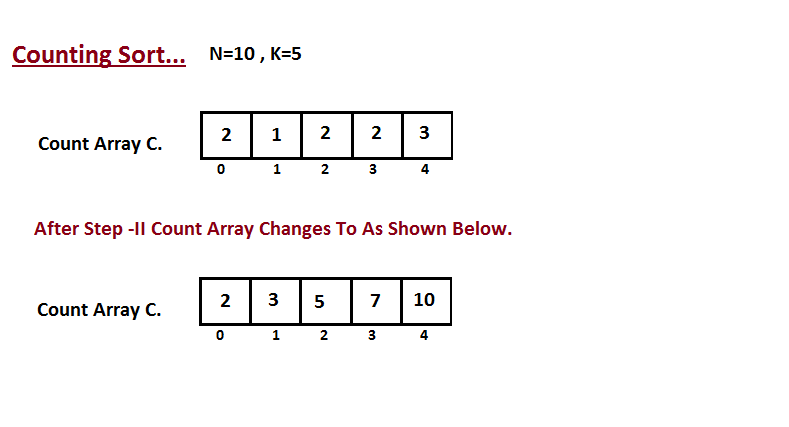
Na segunda etapa, calculamos quantos elementos existem na entrada
|
||||
do vetor `A` que são menores ou iguais para o índice fornecido.
|
||||
`Ci` = números de elementos menores ou iguais a `i` no vetor de entrada.
|
||||
|
||||
|
||||
|
||||
**Passo III**
|
||||
|
||||
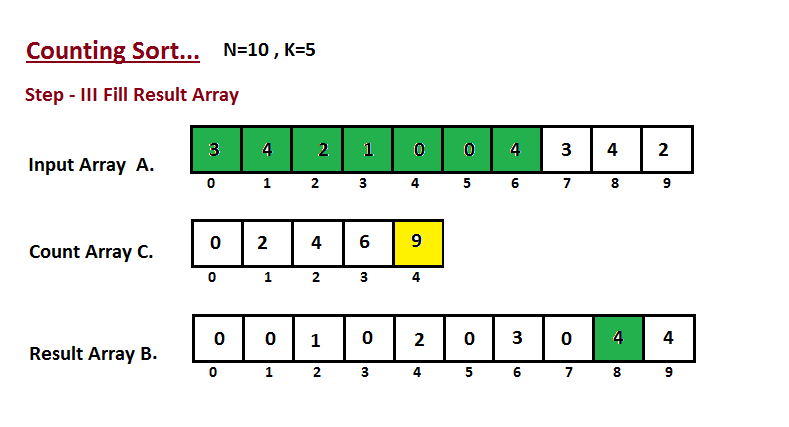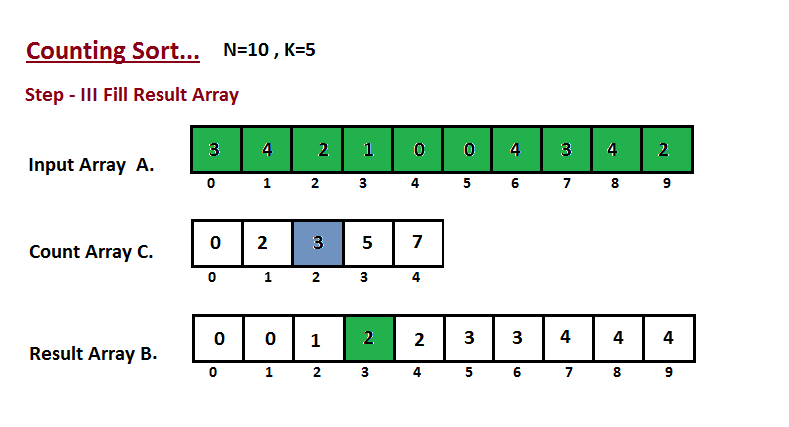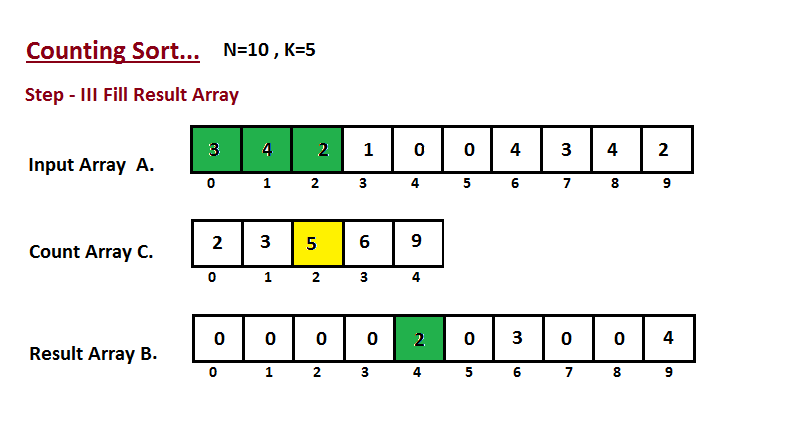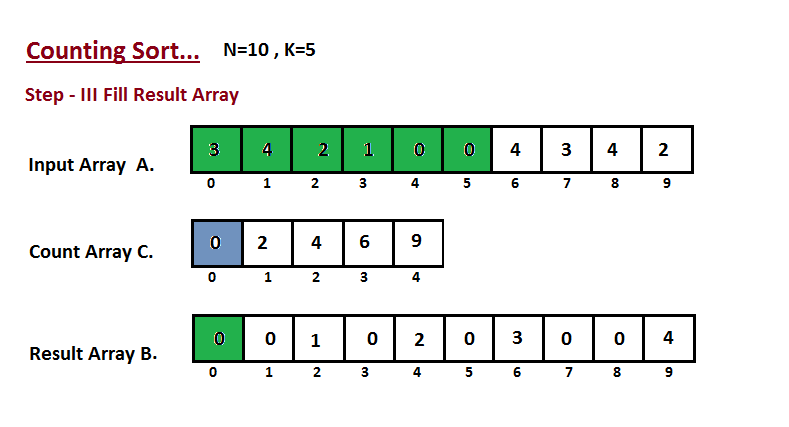
Nesta etapa, colocamos o elemento `A` do vetor de entrada em classificado
|
||||
posição usando a ajuda do vetor de contagem construída `C`, ou seja, o que
|
||||
construímos no passo dois. Usamos o vetor de resultados `B` para armazenar
|
||||
os elementos ordenados. Aqui nós lidamos com o índice de `B` começando de
|
||||
zero.
|
||||
|
||||
|
||||
|
||||
## Complexidade
|
||||
|
||||
| Nome | Melhor | Média | Pior | Memória | Estável | Comentários |
|
||||
| --------------------- | :-------------: | :-----------------: | :-----------------: | :-------: | :-------: | :-------- |
|
||||
| **Counting sort** | n + r | n + r | n + r | n + r | Sim | r - Maior número no vetor |
|
||||
|
||||
## Referências
|
||||
|
||||
- [Wikipedia](https://en.wikipedia.org/wiki/Counting_sort)
|
||||
- [YouTube](https://www.youtube.com/watch?v=OKd534EWcdk&index=61&t=0s&list=PLLXdhg_r2hKA7DPDsunoDZ-Z769jWn4R8)
|
||||
- [EfficientAlgorithms](https://efficientalgorithms.blogspot.com/2016/09/lenear-sorting-counting-sort.html)
|
||||
@@ -1,5 +1,8 @@
|
||||
# Heap Sort
|
||||
|
||||
_Read this in other languages:_
|
||||
[_Português_](README.pt-BR.md)
|
||||
|
||||
Heapsort is a comparison-based sorting algorithm.
|
||||
Heapsort can be thought of as an improved selection
|
||||
sort: like that algorithm, it divides its input into
|
||||
|
||||
20
src/algorithms/sorting/heap-sort/README.pt-BR.md
Normal file
20
src/algorithms/sorting/heap-sort/README.pt-BR.md
Normal file
@@ -0,0 +1,20 @@
|
||||
# Heap Sort
|
||||
|
||||
_Leia isso em outros idiomas:_
|
||||
[_English_](README.md)
|
||||
|
||||
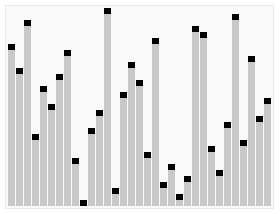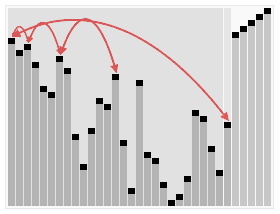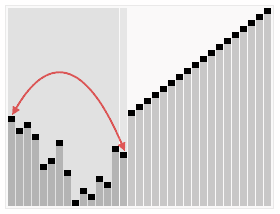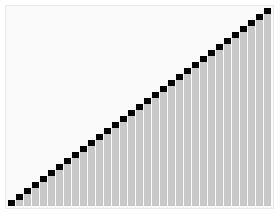
Heapsort é um algoritmo de ordenação baseado em comparação. O Heapsort pode ser pensado como uma seleção aprimorada sort: como esse algoritmo, ele divide sua entrada em uma região classificada e uma região não classificada, e iterativamente encolhe a região não classificada extraindo o maior elemento e movendo-o para a região classificada. A melhoria consiste no uso de uma estrutura de dados heap em vez de uma busca em tempo linear para encontrar o máximo.
|
||||
|
||||
|
||||
|
||||

|
||||
|
||||
## Complexidade
|
||||
|
||||
| Nome | Melhor | Média | Pior | Memória | Estável | Comentários |
|
||||
| --------------------- | :-------------: | :-----------------: | :-----------------: | :-------: | :-------: | :-------- |
|
||||
| **Heap sort** | n log(n) | n log(n) | n log(n) | 1 | Não | |
|
||||
|
||||
## Referências
|
||||
|
||||
[Wikipedia](https://en.wikipedia.org/wiki/Heapsort)
|
||||
@@ -1,5 +1,8 @@
|
||||
# Insertion Sort
|
||||
|
||||
_Read this in other languages:_
|
||||
[_Português_](README.pt-BR.md)
|
||||
|
||||
Insertion sort is a simple sorting algorithm that builds
|
||||
the final sorted array (or list) one item at a time.
|
||||
It is much less efficient on large lists than more
|
||||
|
||||
22
src/algorithms/sorting/insertion-sort/README.pt-BR.md
Normal file
22
src/algorithms/sorting/insertion-sort/README.pt-BR.md
Normal file
@@ -0,0 +1,22 @@
|
||||
# Insertion Sort
|
||||
|
||||
_Leia isso em outros idiomas:_
|
||||
[_English_](README.md)
|
||||
|
||||
A ordenação por inserção é um algoritmo de ordenação simples que criaa matriz classificada final (ou lista) um item de cada vez.
|
||||
É muito menos eficiente em grandes listas do que mais algoritmos avançados, como quicksort, heapsort ou merge
|
||||
ordenar.
|
||||
|
||||
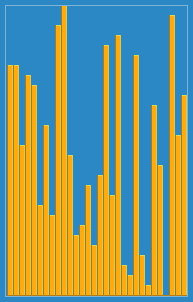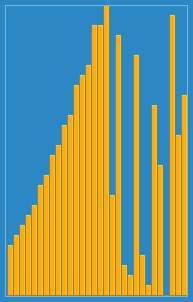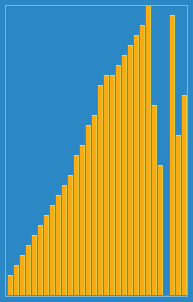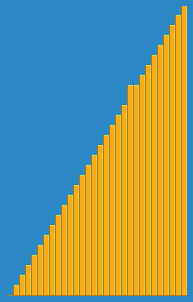
|
||||
|
||||
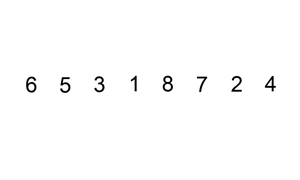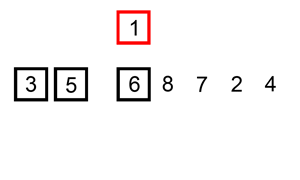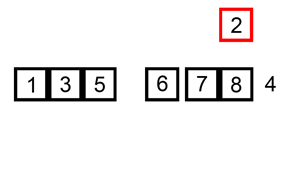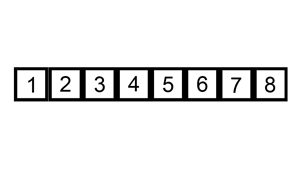
|
||||
|
||||
## Complexidade
|
||||
|
||||
| Nome | Melhor | Média | Pior | Memória | Estável | Comentários |
|
||||
| --------------------- | :-------------: | :-----------------: | :-----------------: | :-------: | :-------: | :-------- |
|
||||
| **Insertion sort** | n | n<sup>2</sup> | n<sup>2</sup> | 1 | Sim | |
|
||||
|
||||
## Referências
|
||||
|
||||
[Wikipedia](https://en.wikipedia.org/wiki/Insertion_sort)
|
||||
@@ -1,7 +1,8 @@
|
||||
# Merge Sort
|
||||
|
||||
_Read this in other languages:_
|
||||
[_한국어_](README.ko-KR.md)
|
||||
[_한국어_](README.ko-KR.md),
|
||||
[_Português_](README.pt-BR.md)
|
||||
|
||||
In computer science, merge sort (also commonly spelled
|
||||
mergesort) is an efficient, general-purpose,
|
||||
|
||||
38
src/algorithms/sorting/merge-sort/README.pt-BR.md
Normal file
38
src/algorithms/sorting/merge-sort/README.pt-BR.md
Normal file
@@ -0,0 +1,38 @@
|
||||
# Merge Sort
|
||||
|
||||
_Leia isso em outros idiomas:_
|
||||
[_한국어_](README.ko-KR.md),
|
||||
[_English_](README.md)
|
||||
|
||||
Em ciência da computação, merge sort (também comumente escrito
|
||||
mergesort) é uma ferramenta eficiente, de propósito geral,
|
||||
algoritmo de ordenação baseado em comparação. A maioria das implementações
|
||||
produzir uma classificação estável, o que significa que a implementação
|
||||
preserva a ordem de entrada de elementos iguais na ordenação
|
||||
resultado. Mergesort é um algoritmo de divisão e conquista que
|
||||
foi inventado por John von Neumann em 1945.
|
||||
|
||||
Um exemplo de classificação de mesclagem. Primeiro divida a lista em
|
||||
a menor unidade (1 elemento), então compare cada
|
||||
elemento com a lista adjacente para classificar e mesclar o
|
||||
duas listas adjacentes. Finalmente todos os elementos são ordenados
|
||||
e mesclado.
|
||||
|
||||
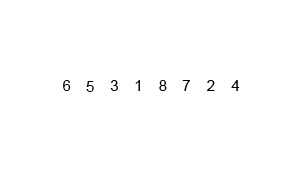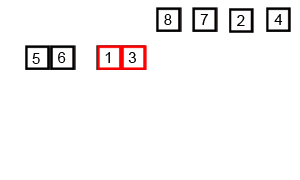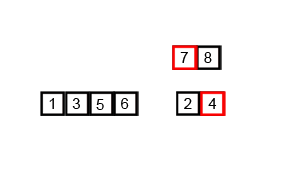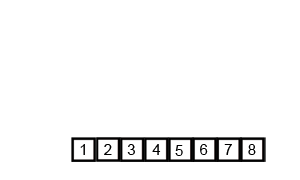
|
||||
|
||||
Um algoritmo de classificação de mesclagem recursivo usado para classificar uma matriz de 7
|
||||
valores inteiros. Estes são os passos que um ser humano daria para
|
||||
emular merge sort (top-down).
|
||||
|
||||

|
||||
|
||||
## Complexidade
|
||||
|
||||
| Nome | Melhor | Média | Pior | Memória | Estável | Comentários |
|
||||
| --------------------- | :-------------: | :-----------------: | :-----------------: | :-------: | :-------: | :-------- |
|
||||
| **Merge sort** | n log(n) | n log(n) | n log(n) | n | Sim | |
|
||||
|
||||
## Referências
|
||||
|
||||
- [Wikipedia](https://en.wikipedia.org/wiki/Merge_sort)
|
||||
- [YouTube](https://www.youtube.com/watch?v=KF2j-9iSf4Q&index=27&list=PLLXdhg_r2hKA7DPDsunoDZ-Z769jWn4R8)
|
||||
@@ -1,8 +1,8 @@
|
||||
# Quicksort
|
||||
|
||||
_Read this in other languages:_
|
||||
[_Português_](README.pt-BR.md),
|
||||
[_简体中文_](README.zh-CN.md)
|
||||
[_简体中文_](README.zh-CN.md),
|
||||
[_Português_](README.pt-BR.md)
|
||||
|
||||
Quicksort is a divide and conquer algorithm.
|
||||
Quicksort first divides a large array into two smaller
|
||||
|
||||
@@ -1,15 +1,19 @@
|
||||
# Quicksort
|
||||
|
||||
Quicksort é um algoritmo de dividir para conquistar é um algoritmo de divisão e conquista.
|
||||
_Leia isso em outros idiomas:_
|
||||
[_简体中文_](README.zh-CN.md),
|
||||
[_English_](README.md)
|
||||
|
||||
Quicksort é um algoritmo de dividir para conquistar.
|
||||
Quicksort primeiro divide uma grande matriz em duas menores
|
||||
submatrizes: os elementos baixos e os elementos altos.
|
||||
O Quicksort pode então classificar recursivamente as submatrizes
|
||||
O Quicksort pode então classificar recursivamente as submatrizes.
|
||||
|
||||
As etapas são:
|
||||
|
||||
1. Escolha um elemento, denominado pivô, na matriz.
|
||||
2. Particionamento: reordene a matriz para que todos os elementos com
|
||||
valores menores que o pivô vêm antes do pivô, enquanto todos
|
||||
valores menores que o pivô estejam antes do pivô, enquanto todos
|
||||
elementos com valores maiores do que o pivô vêm depois dele
|
||||
(valores iguais podem ser usados em qualquer direção). Após este particionamento,
|
||||
o pivô está em sua posição final. Isso é chamado de
|
||||
@@ -27,7 +31,7 @@ As linhas horizontais são valores dinâmicos.
|
||||
|
||||
| Nome | Melhor | Média | Pior | Memória | Estável | Comentários |
|
||||
| --------------------- | :-------------: | :-----------------: | :-----------------: | :-------: | :-------: | :-------- |
|
||||
| **Quick sort** | n log(n) | n log(n) | n<sup>2</sup> | log(n) | No | Quicksort geralmente é feito no local com espaço de pilha O(log(n)) |
|
||||
| **Quick sort** | n log(n) | n log(n) | n<sup>2</sup> | log(n) | Não | Quicksort geralmente é feito no local com espaço de pilha O(log(n)) |
|
||||
|
||||
## Referências
|
||||
|
||||
|
||||
@@ -1,5 +1,8 @@
|
||||
# Radix Sort
|
||||
|
||||
_Read this in other languages:_
|
||||
[_Português_](README.pt-BR.md),
|
||||
|
||||
In computer science, **radix sort** is a non-comparative integer sorting
|
||||
algorithm that sorts data with integer keys by grouping keys by the individual
|
||||
digits which share the same significant position and value. A positional notation
|
||||
|
||||
48
src/algorithms/sorting/radix-sort/README.pt-BR.md
Normal file
48
src/algorithms/sorting/radix-sort/README.pt-BR.md
Normal file
@@ -0,0 +1,48 @@
|
||||
# Radix Sort
|
||||
|
||||
_Leia isso em outros idiomas:_
|
||||
[_English_](README.md)
|
||||
|
||||
Em ciência da computação, **radix sort** é uma classificação inteira não comparativa
|
||||
algoritmo que classifica os dados com chaves inteiras agrupando as chaves pelo indivíduo
|
||||
dígitos que compartilham a mesma posição e valor significativos. Uma notação posicional
|
||||
é necessário, mas porque os números inteiros podem representar cadeias de caracteres
|
||||
(por exemplo, nomes ou datas) e números de ponto flutuante especialmente formatados, base
|
||||
sort não está limitado a inteiros.
|
||||
|
||||
*De onde vem o nome?*
|
||||
|
||||
Em sistemas numéricos matemáticos, a *radix* ou base é o número de dígitos únicos,
|
||||
incluindo o dígito zero, usado para representar números em um sistema de numeração posicional.
|
||||
Por exemplo, um sistema binário (usando números 0 e 1) tem uma raiz de 2 e um decimal
|
||||
sistema (usando números de 0 a 9) tem uma raiz de 10.
|
||||
|
||||
## Eficiência
|
||||
|
||||
O tópico da eficiência do radix sort comparado a outros algoritmos de ordenação é
|
||||
um pouco complicado e sujeito a muitos mal-entendidos. Se raiz
|
||||
sort é igualmente eficiente, menos eficiente ou mais eficiente do que o melhor
|
||||
algoritmos baseados em comparação depende dos detalhes das suposições feitas.
|
||||
A complexidade de classificação de raiz é `O(wn)` para chaves `n` que são inteiros de tamanho de palavra `w`.
|
||||
Às vezes, `w` é apresentado como uma constante, o que tornaria a classificação radix melhor
|
||||
(para `n` suficientemente grande) do que os melhores algoritmos de ordenação baseados em comparação,
|
||||
que todos realizam comparações `O(n log n)` para classificar chaves `n`. No entanto, em
|
||||
geral `w` não pode ser considerado uma constante: se todas as chaves `n` forem distintas,
|
||||
então `w` tem que ser pelo menos `log n` para que uma máquina de acesso aleatório seja capaz de
|
||||
armazená-los na memória, o que dá na melhor das hipóteses uma complexidade de tempo `O(n log n)`. Este
|
||||
parece tornar a ordenação radix no máximo tão eficiente quanto a melhor
|
||||
ordenações baseadas em comparação (e pior se as chaves forem muito mais longas que `log n`).
|
||||
|
||||

|
||||
|
||||
## Complexidade
|
||||
|
||||
| Nome | Melhor | Média | Pior | Memória | Estável | Comentários |
|
||||
| --------------------- | :-------------: | :-----------------: | :-----------------: | :-------: | :-------: | :-------- |
|
||||
| **Radix sort** | n * k | n * k | n * k | n + k | Sim | k - comprimento da chave mais longa |
|
||||
|
||||
## Referências
|
||||
|
||||
- [Wikipedia](https://en.wikipedia.org/wiki/Radix_sort)
|
||||
- [YouTube](https://www.youtube.com/watch?v=XiuSW_mEn7g&index=62&t=0s&list=PLLXdhg_r2hKA7DPDsunoDZ-Z769jWn4R8)
|
||||
- [ResearchGate](https://www.researchgate.net/figure/Simplistic-illustration-of-the-steps-performed-in-a-radix-sort-In-this-example-the_fig1_291086231)
|
||||
@@ -1,7 +1,7 @@
|
||||
# Selection Sort
|
||||
|
||||
_Read this in other languages:_
|
||||
[Português brasileiro](README.pt-BR.md).
|
||||
[_Português_](README.pt-BR.md).
|
||||
|
||||
Selection sort is a sorting algorithm, specifically an
|
||||
in-place comparison sort. It has O(n2) time complexity,
|
||||
|
||||
@@ -1,7 +1,7 @@
|
||||
# Selection Sort
|
||||
|
||||
_Leia isso em outras línguas:_
|
||||
[english](README.md).
|
||||
_Leia isso em outros idiomas:_
|
||||
[_English_](README.md).
|
||||
|
||||
Selection Sort é um algoritmo de ordenação, mais especificamente um algoritmo de ordenação por comparação in-place (requer uma quantidade constante de espaço de memória adicional). Tem complexidade O(n²), tornando-o ineficiente em listas grandes e, geralmente, tem desempenho inferior ao similar Insertion Sort. O Selection Sort é conhecido por sua simplicidade e tem vantagens de desempenho sobre algoritmos mais complexos em certas situações, particularmente quando a memória auxiliar é limitada.
|
||||
|
||||
|
||||
@@ -1,5 +1,8 @@
|
||||
# Shellsort
|
||||
|
||||
_Read this in other languages:_
|
||||
[_Português_](README.pt-BR.md).
|
||||
|
||||
Shellsort, also known as Shell sort or Shell's method,
|
||||
is an in-place comparison sort. It can be seen as either a
|
||||
generalization of sorting by exchange (bubble sort) or sorting
|
||||
|
||||
60
src/algorithms/sorting/shell-sort/README.pt-BR.md
Normal file
60
src/algorithms/sorting/shell-sort/README.pt-BR.md
Normal file
@@ -0,0 +1,60 @@
|
||||
# Shellsort
|
||||
|
||||
_Leia isso em outros idiomas:_
|
||||
[_English_](README.md).
|
||||
|
||||
Shellsort, também conhecido como Shell sort ou método de Shell,
|
||||
é uma classificação de comparação in-loco. Pode ser visto tanto como um
|
||||
generalização da ordenação por troca (bubble sort) ou ordenação
|
||||
por inserção (ordenação por inserção). O método começa classificando
|
||||
pares de elementos distantes um do outro, então progressivamente
|
||||
reduzindo a distância entre os elementos a serem comparados. Iniciando
|
||||
com elementos distantes, pode mover alguns fora do lugar
|
||||
elementos em posição mais rápido do que um simples vizinho mais próximo
|
||||
intercâmbio
|
||||
|
||||

|
||||
|
||||
## Como o Shellsort funciona?
|
||||
|
||||
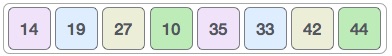
Para nosso exemplo e facilidade de compreensão, tomamos o intervalo
|
||||
de `4`. Faça uma sub-lista virtual de todos os valores localizados no
|
||||
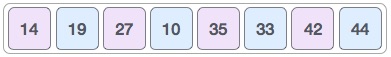
intervalo de 4 posições. Aqui esses valores são
|
||||
`{35, 14}`, `{33, 19}`, `{42, 27}` e `{10, 44}`
|
||||
|
||||

|
||||
|
||||
Comparamos valores em cada sublista e os trocamos (se necessário)
|
||||
na matriz original. Após esta etapa, o novo array deve
|
||||
parece com isso
|
||||
|
||||
|
||||
|
||||
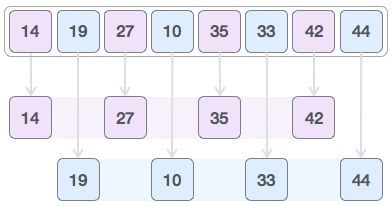
Então, pegamos o intervalo de 2 e essa lacuna gera duas sub-listas
|
||||
- `{14, 27, 35, 42}`, `{19, 10, 33, 44}`
|
||||
|
||||
|
||||
|
||||
Comparamos e trocamos os valores, se necessário, no array original.
|
||||
Após esta etapa, a matriz deve ficar assim
|
||||
|
||||
|
||||
|
||||
> OBS: Na imagem abaixo há um erro de digitação e a matriz de resultados deve ser `[14, 10, 27, 19, 35, 33, 42, 44]`.
|
||||
|
||||
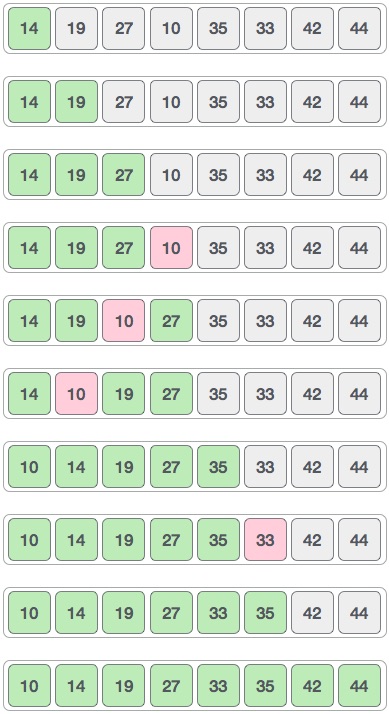
Finalmente, ordenamos o resto do array usando o intervalo de valor 1.
|
||||
A classificação de shell usa a classificação por inserção para classificar a matriz.
|
||||
|
||||
|
||||
|
||||
## Complexidade
|
||||
|
||||
| Nome | Melhor | Média | Pior | Memória | Estável | Comentários |
|
||||
| --------------------- | :-------------: | :-----------------: | :-----------------: | :-------: | :-------: | :-------- |
|
||||
| **Shell sort** | n log(n) | depends on gap sequence | n (log(n))<sup>2</sup> | 1 | Não | |
|
||||
|
||||
## Referências
|
||||
|
||||
- [Tutorials Point](https://www.tutorialspoint.com/data_structures_algorithms/shell_sort_algorithm.htm)
|
||||
- [Wikipedia](https://en.wikipedia.org/wiki/Shellsort)
|
||||
- [YouTube by Rob Edwards](https://www.youtube.com/watch?v=ddeLSDsYVp8&index=79&list=PLLXdhg_r2hKA7DPDsunoDZ-Z769jWn4R8)
|
||||
Reference in New Issue
Block a user